
J'ai restauré mes sauvegardes PostgreSQL pour de vrai. Le premier essai a échoué.
« Sauvegarde OK. » C'est la ligne que mon cron écrit tous les matins depuis des mois. Elle dit une seule chose : un fichier a été écrit quelque part. Rien de plus.
Une sauvegarde qu'on n'a jamais restaurée n'est pas une sauvegarde. C'est une hypothèse, et on découvre si elle était juste le pire jour de l'année. J'ai vu une base perdue que tout le monde croyait protégée : le cron tournait depuis des années, il disait OK, et la restauration s'est arrêtée à mi-chemin.
Alors j'ai arrêté d'attendre. Mes six PostgreSQL tournent chez moi, sur un Raspberry Pi, derrière le VPN. Chaque semaine, une machine jetable restaure la dernière sauvegarde, démarre la copie, regarde dedans et écrit un rapport.
Le premier essai a échoué
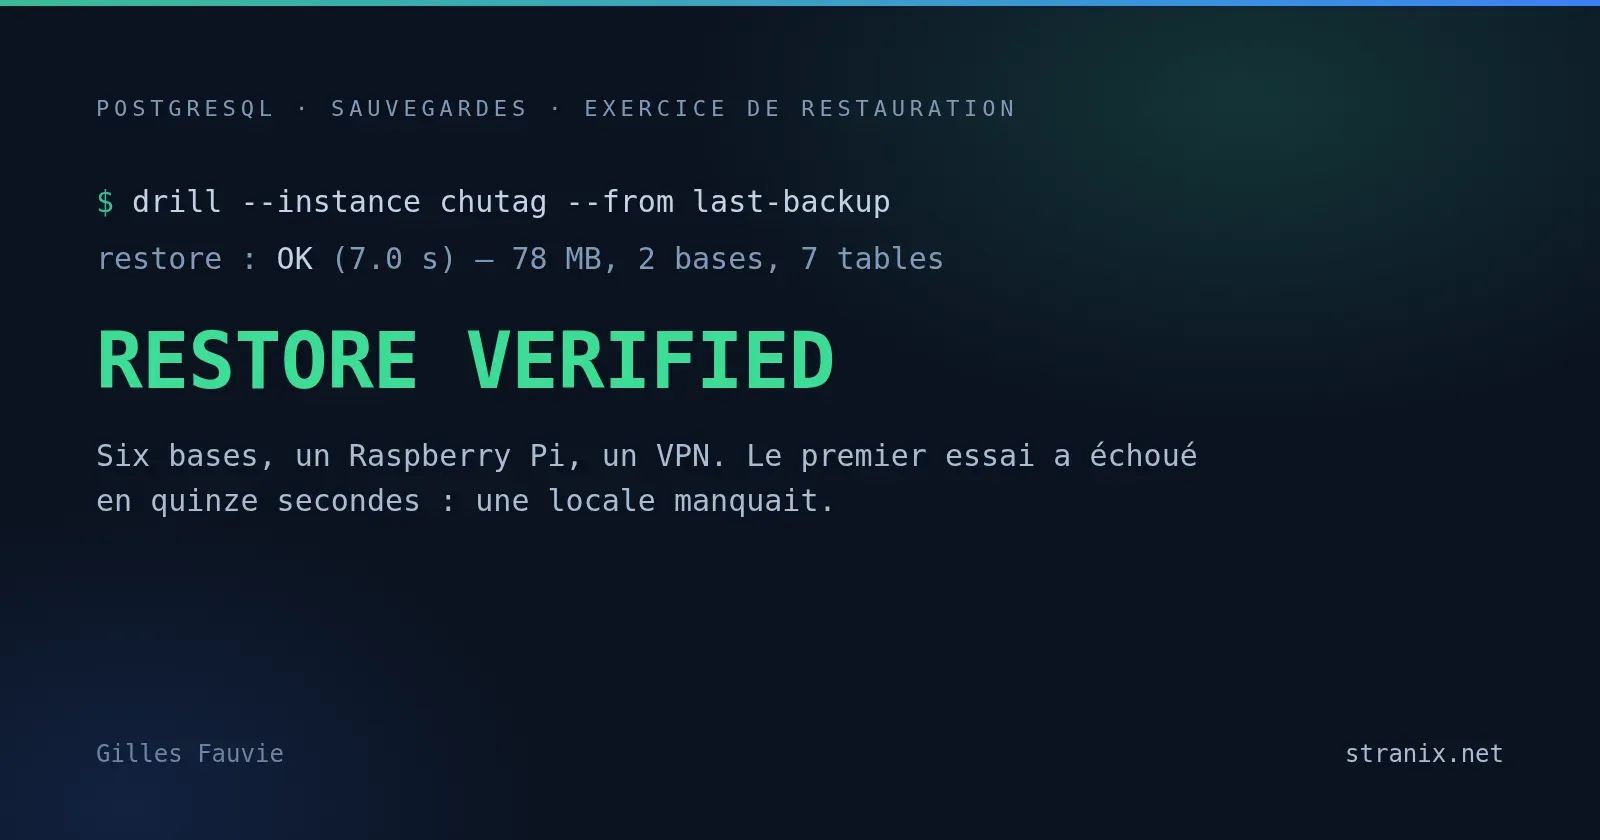
Quinze secondes, et rien n'a démarré. Une locale manquait dans l'image de la machine jetable. Rien de spectaculaire, et exactement le genre de détail qui te tue un soir d'incident : personne ne le voit tant qu'on ne restaure pas pour de vrai.
Corrigé, relancé : la base chutag restaurée, démarrée et interrogée en 7 secondes. 78 Mo, deux bases, sept tables. Le rapport dit RESTORE VERIFIED. C'est la seule phrase que je veux lire le lundi matin. J'en ai parlé en détail quand j'ai mis l'outil en ligne : pgCellar, ou comment transformer une hypothèse en preuve.
Ce qui casse vraiment
Une restauration échoue rarement pour la raison qu'on imagine. Voici ce que je rencontre, dans l'ordre :
- Un trou dans les archives WAL. La sauvegarde de base est saine, un segment manque quelque part : la restauration à un instant donné s'arrête en route.
- La phrase de passe de chiffrement est restée sur le serveur qui a brûlé. La sauvegarde est intacte et illisible.
- Le temps de reprise n'a jamais été mesuré. 800 Go à 100 Mo/s, c'est plus de deux heures rien qu'en copie de fichiers. Le contrat, lui, promet une heure.
- La rétention a été raccourcie pour économiser du stockage : la dernière sauvegarde saine est plus vieille que ce que l'entreprise accepterait de perdre.
- La procédure vit dans la tête d'une seule personne, et cette personne est partie.
Aucun de ces cinq points n'apparaît dans un tableau de bord vert.
Deux chiffres à mesurer, pas à souhaiter
RTO : combien de temps avant que la base réponde à nouveau. RPO : combien de minutes de données tu acceptes de perdre. Si tu ne les as jamais mesurés sur une vraie restauration, ce sont des souhaits.
Un exercice, six étapes, un après-midi
- Prends un hôte jetable, avec la même version majeure de PostgreSQL.
- Restaure la dernière sauvegarde complète. Chronomètre.
- Restaure à un instant précis, par exemple « il y a trois heures ». Vérifie que la base s'ouvre.
- Compte les lignes des tables critiques et compare avec la production.
- Note tout ce qui t'a demandé d'improviser. C'est là qu'est le risque réel.
- Recommence dans trois mois. Une restauration testée vieillit vite.
Et si tu peux, automatise-le. C'est ce que fait pgCellar chez moi : il pilote Barman par sa ligne de commande, restaure chaque semaine, démarre la copie et écrit le rapport. Un binaire Go, une configuration en fichiers texte versionnés, aucun compte à créer chez personne.
Pour l'auditeur, pas pour la beauté
NIS2 et les assureurs cyber posent tous la même question : montre-moi que ça se restaure. Pendant quinze ans, on a répondu par une promesse. Un PDF daté, avec des chiffres mesurés et un nom dessus, se lit sans compte ni outil. Je ne suis pas juriste : vérifie avec le tien ce qui s'applique à ton entité.
Si tu n'as pas envie de monter ça
Je le fais pour toi. Restore Check : je restaure ta dernière sauvegarde et un point dans le temps, avec ton outil et sur ton matériel, je mesure le RTO et le RPO, je liste les écarts, et je te remets un rapport PDF daté et signé sous cinq jours ouvrés avec un appel de restitution de 45 minutes. Jusqu'à trois instances PostgreSQL, 1 490 € HT, prix fixe.
Demander un Restore Check — ou automatiser l'exercice avec pgCellar, gratuit jusqu'à deux serveurs en usage interne.
Gilles Fauvie, dbfactory